LA MONTAÑA
Modelos y algoritmos de visión artificial
| IMAGEN | OBRA | FICHA | |
|---|---|---|---|
| 01 | 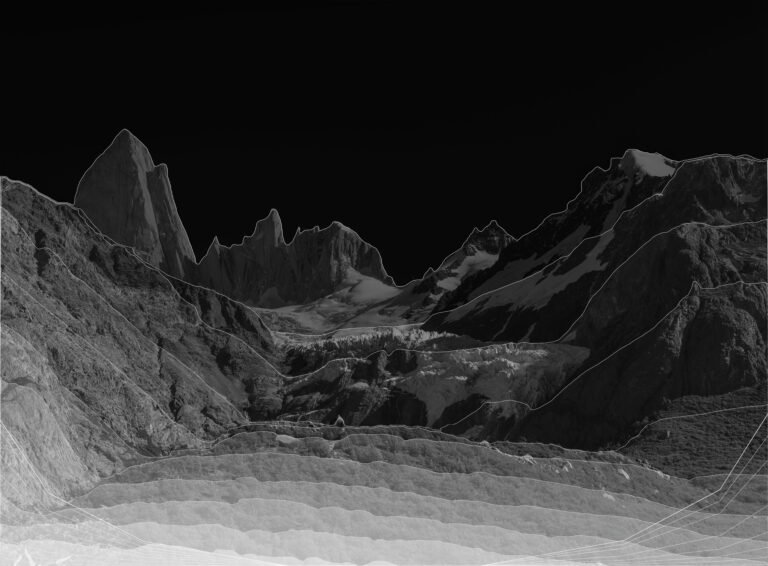 | Depth Anything (V2).Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Depth Anything V2 (2024) Régimen geométrico. La fotografía se ordena de lo cercano a lo lejano en una escala que solo vale dentro de este cuadro: un paisaje topográfico sin metros. Depth Anything V2 (2024) es una red neuronal: lo que devuelve depende de las imágenes con que fue entrenada. Ordena cada píxel según su distancia a la cámara, pero no expresa esa distancia en metros. Según sus autores, fue diseñado para obtener, con una sola imagen, mapas de profundidad más finos y más confiables que los de su versión anterior. Para entrenarlo usaron imágenes sintéticas, hechas por computadora, en lugar de fotografías reales acompañadas de su profundidad; con ellas entrenaron un modelo grande, que luego enseñó a modelos más chicos con una gran cantidad de fotografías reales. Se publicó en varios tamaños. En el valle del Glaciar Piedras Blancas se usó la versión más chica (Small), con la fotografía reducida a 518 píxeles de lado; el script dibuja la profundidad devuelta en 12 franjas. MÁS INFO Depth Anything V2 · Lihe Yang, Hengshuang Zhao (HKU) · Bingyi Kang, Zilong Huang, Jiashi Feng (TikTok) · Zhen Zhao, Xiaogang Xu · 2024Yang, L., Kang, B., Huang, Z., Zhao, Z., Xu, X., Feng, J. y Zhao, H. (2024). Depth Anything V2. arxiv.org/abs/2406.09414 |
| 02 | 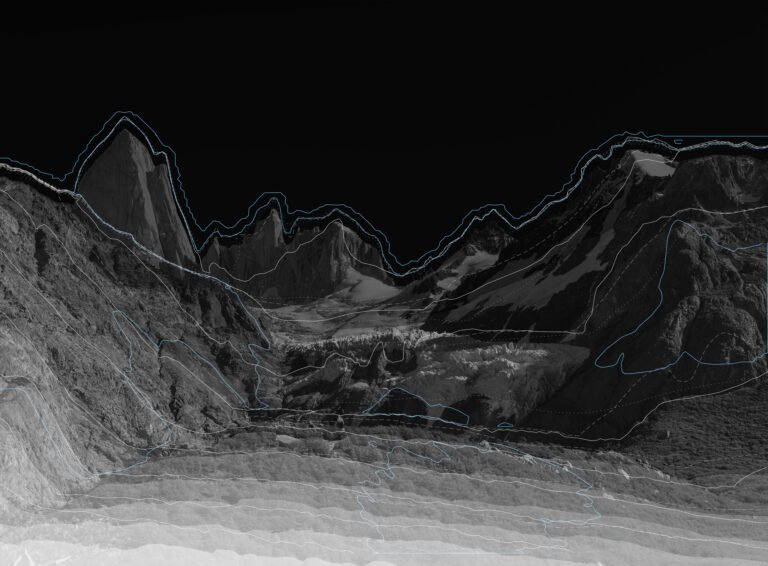 | Escala inventada.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Depth Anything V2 Large (2024) Régimen epistémico. La misma foto, entregada en tres tamaños, pone a prueba si el orden de lo cercano y lo lejano se sostiene o se invierte: un paisaje de incertidumbre. Aquí corre la versión grande (Large) de Depth Anything V2 (2024), una red neuronal cuya respuesta depende de su entrenamiento. Estima para cada píxel cuán cerca o lejos está de la cámara, en una escala relativa, sin metros. Según sus autores, fue diseñado para obtener mapas de profundidad finos y confiables desde una sola imagen. Su entrenamiento combina imágenes hechas por computadora, un modelo grande que enseña a otros más chicos y una gran cantidad de fotografías reales. Frente al Glaciar Piedras Blancas, el script le entregó la fotografía al modelo en tres tamaños —252 × 196, 518 × 378 y 1036 × 770 píxeles— y contrastó los tres resultados punto por punto. Entre el tamaño menor y el mayor, el 3,3 % de los pares de puntos invierte su orden: lo que en una versión queda más cerca, en otra queda más lejos. En esta fotografía el orden se mantuvo estable. MÁS INFO Depth Anything V2 · Lihe Yang, Hengshuang Zhao (HKU) · Bingyi Kang, Zilong Huang, Jiashi Feng (TikTok) · Zhen Zhao, Xiaogang Xu · 2024Yang, L., Kang, B., Huang, Z., Zhao, Z., Xu, X., Feng, J. y Zhao, H. (2024). Depth Anything V2. arxiv.org/abs/2406.09414 |
| 03 | 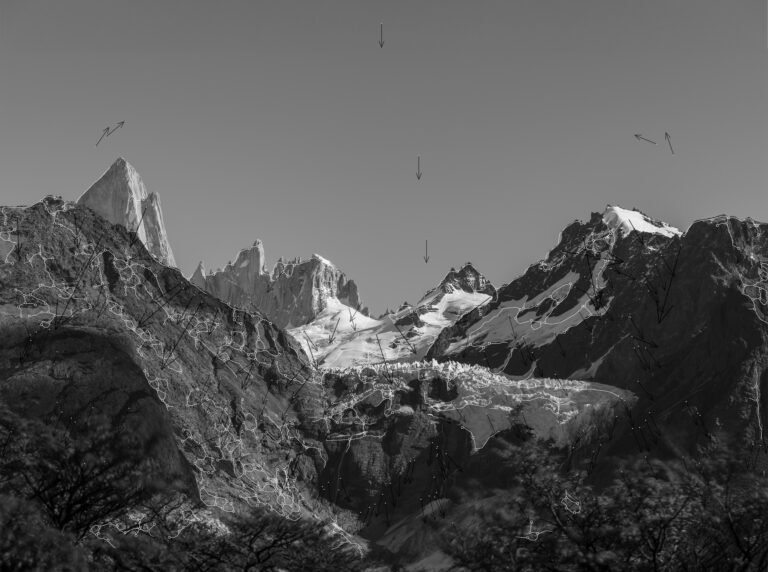 | Filtro de Frangi (1998) y modelo de incisión por poder de corriente (1999).Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Filtro de Frangi (1998) y modelo de incisión por poder de corriente (1999) Un filtro pensado para vasos sanguíneos, aplicado al valle del Glaciar Piedras Blancas: qué filamentos claros recorren la superficie, de qué grosor y cómo se ramifican. Régimen material; paisaje físico. El filtro de Frangi es un algoritmo (una fórmula fija, sin entrenamiento): resalta las formas finas y alargadas de una imagen, en varios grosores a la vez. Después, el script reduce cada una de esas formas a una línea de un píxel de ancho (algoritmo de Zhang y Suen), las organiza como una red de ramas y les asigna un nivel de ramificación (orden de Strahler). El filtro fue presentado en 1998, en una conferencia internacional de imágenes médicas, como un método para resaltar vasos sanguíneos. El modelo de incisión por poder de corriente es una fórmula de la geomorfología: calcula cuánto erosiona un río su lecho de roca a partir del área que drena y de la pendiente del cauce. En 1999, Kelin Whipple y Gregory Tucker lo revisaron para estudiar cómo limita la altura de las cordilleras y cuánto tarda un paisaje en responder a cambios tectónicos y climáticos. Sobre el valle del Glaciar Piedras Blancas, el filtro buscó formas claras de entre 1,25 y 5,21 píxeles de grosor. El script obtuvo 620 ramas y 571 bifurcaciones, con tres niveles de ramificación. MÁS INFO Frangi, A. F., Niessen, W. J., Vincken, K. L. y Viergever, M. A. (1998). Multiscale vessel enhancement filtering. MICCAI, Lecture Notes in Computer Science, 130–137. doi.org/10.1007/BFb0056195Zhang, T. Y. y Suen, C. Y. (1984). A fast parallel algorithm for thinning digital patterns. Communications of the ACM, 27(3), 236–239. doi.org/10.1145/357994.358023 Whipple, K. X. y Tucker, G. E. (1999). Dynamics of the stream-power river incision model. Journal of Geophysical Research: Solid Earth, 104(B8), 17661–17674. doi.org/10.1029/1999JB900120 |
| 04 | 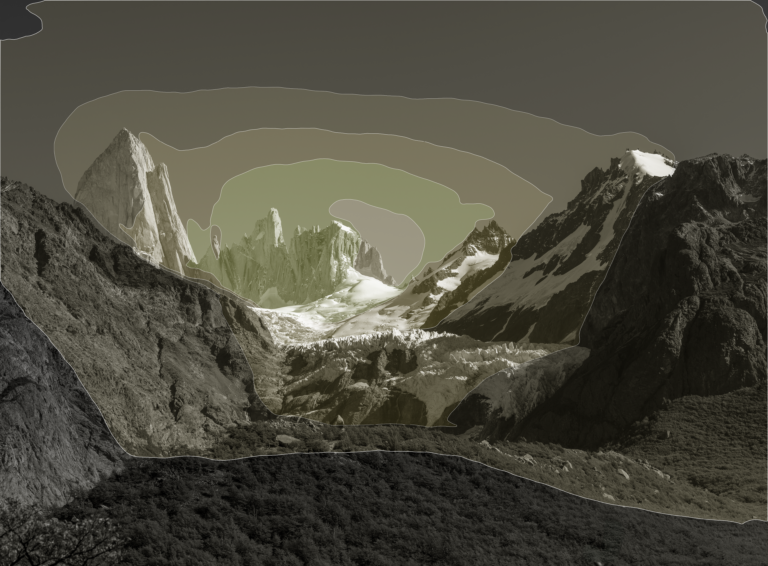 | ZoeDepth (2023).Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | ZoeDepth (2023) Procesamiento analítico de descomposición espacial. Devela las directrices y tensiones que articulan el régimen geométrico de la imagen: qué está cerca, qué está lejos y a cuántos metros. El modelo ZoeDepth (2023) es una red neuronal entrenada con imágenes; lo que devuelve depende de ese entrenamiento. Transforma la fotografía en un mapa de profundidad, donde el valor de cada píxel representa la distancia estimada (en metros) a la que se encuentra ese punto respecto de la cámara. Según sus autores, fue diseñado para aplicaciones de visión artificial y robótica, como la construcción de mapas. Sobre el valle del Glaciar Piedras Blancas, el modelo asignó a toda la imagen, del primer plano a las cumbres, distancias de entre 6,3 y 34,6 metros. El script las dibuja en cinco curvas de nivel, de 8,9 a 31,5 metros. MÁS INFO ZoeDepth · Shariq Farooq Bhat, Peter Wonka (KAUST) · Reiner Birkl, Diana Wofk, Matthias Müller (Intel) · 2023Bhat, S. F., Birkl, R., Wofk, D., Wonka, P. y Müller, M. (2023). ZoeDepth: Zero-shot Transfer by Combining Relative and Metric Depth. arxiv.org/abs/2302.12288 |
| 05 | 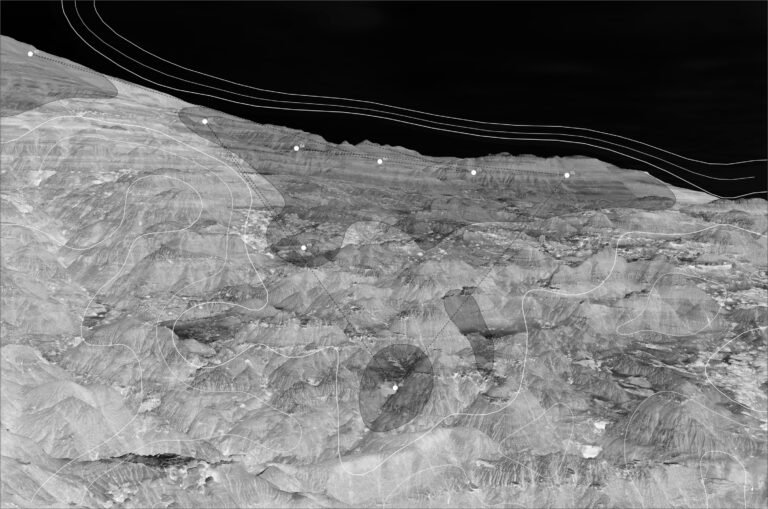 | Saliencia clásica: residuo espectral (Hou y Zhang) e Itti-Koch / Inhibición de retorno (Algoritmo Koch-Ullman).Target: Bosque Petrificado La Leona. Timestamp: 2025-2026 | Residuo espectral (2007) y modelo de Itti-Koch Atención sin ojos y sin entrenamiento: fórmulas fijas calculan qué zonas del cuadro se destacan de su entorno. Régimen cognitivo, en un paisaje de la atención hecho solo de contraste. No es una red neuronal ni se entrena con ejemplos. El script suma tres mapas calculados con fórmulas. Uno, de Hou y Zhang (residuo espectral), se calcula sobre las frecuencias que componen la imagen. Los otros dos, según el modelo de Itti y Koch, contrastan cada zona con lo que la rodea: en brillo y en la dirección de sus líneas. Además, el script da más peso al centro del cuadro. El método de Hou y Zhang fue presentado en 2007 como una técnica para detectar las zonas que se destacan en una imagen (saliencia). Sobre el Bosque Petrificado La Leona, la mitad de la atención calculada se concentra en el 32,7 % del cuadro. Los 8 puntos numerados son un recorrido: van del más destacado al menos destacado y no vuelven cerca de un punto ya marcado (regla de inhibición de retorno, de Koch y Ullman). MÁS INFO Hou, X. y Zhang, L. (2007). Saliency detection: A spectral residual approach. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 1–8. doi.org/10.1109/CVPR.2007.383267Itti, L., Koch, C. y Niebur, E. (1998). A model of saliency-based visual attention for rapid scene analysis. IEEE Transactions on Pattern Analysis and Machine Intelligence, 20(11), 1254–1259. doi.org/10.1109/34.730558 |
| 06 | 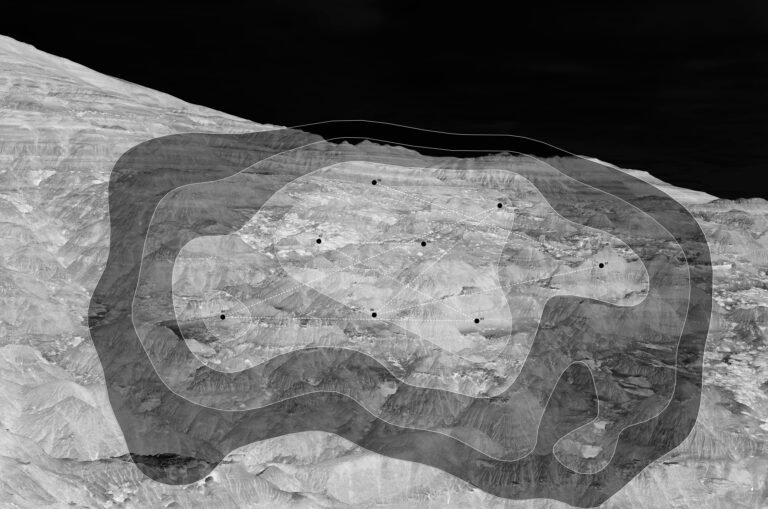 | Modelo DeepGaze IIE / Inhibición de retorno (Algoritmo Koch-Ullman).Target: Bosque Petrificado La Leona. Timestamp: 2025-2026 | DeepGaze IIE (2021) Dónde va el ojo humano frente a la fotografía, según una red que predice hacia dónde miran las personas: el régimen cognitivo convertido en un paisaje de la atención. DeepGaze IIE (2021) es una red neuronal; sus predicciones dependen de los datos con que fue entrenada. Devuelve un mapa de los lugares de una imagen donde es más probable que se detenga la mirada de una persona. Según sus autores, fue diseñado para predecir mejor esas zonas, también en imágenes distintas de las que usaron para entrenarlo. Para eso combina varias redes y corrige el exceso de confianza que esas redes muestran ante imágenes que no conocen. El script suma, además, la tendencia a mirar hacia el centro que distribuyen los autores, calculada sobre el conjunto de datos MIT1003. En el Bosque Petrificado La Leona, cada curva encierra una parte de la atención predicha: un cuarto cae en el 8,2 % del cuadro; la mitad, en el 18,9 %; tres cuartos, en el 34,4 %; y el 90 %, en la mitad del cuadro. Los 8 puntos numerados van del lugar más probable al menos probable, sin volver cerca de uno ya marcado. MÁS INFO DeepGaze IIE · Akis Linardos, Matthias Kümmerer, Ori Press, Matthias Bethge · 2021Linardos, A., Kümmerer, M., Press, O. y Bethge, M. (2021). DeepGaze IIE: Calibrated prediction in and out-of-domain for state-of-the-art saliency modeling. arxiv.org/abs/2105.12441 |
| 07 | 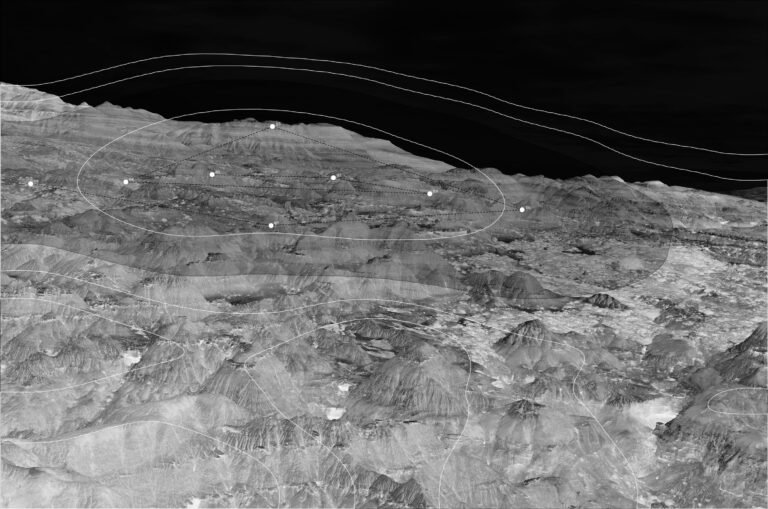 | Modelo Grad-CAM (Gradient-weighted Class Activation Mapping).Target: Bosque Petrificado La Leona. Timestamp: 2025-2026 | Grad-CAM (2016) sobre ResNet-50 (2015) La atención ya no es humana: son las zonas en las que una red neuronal se apoyó para clasificar la fotografía. Régimen cognitivo; paisaje de la atención de una máquina. Intervienen dos cosas. ResNet-50 (2015) es una red neuronal que asigna una imagen a una de mil categorías, según su entrenamiento. Grad-CAM (2016) es un método que se aplica después, sobre esa red ya entrenada: calcula qué zonas de la imagen pesaron más en la categoría asignada. Según sus autores, Grad-CAM fue diseñado para hacer visibles las decisiones de las redes neuronales: mostrar sobre la imagen en qué zonas se apoyan. La versión de ResNet-50 usada aquí fue entrenada con ImageNet, un conjunto de imágenes organizado en mil categorías. Para la red, este paisaje de La Leona es un «cliff dwelling» (vivienda en acantilado), la categoría 500 de esas mil. Cada curva encierra una parte del peso calculado: un cuarto cae en el 11 % del cuadro; la mitad, en el 27,4 %; tres cuartos, en el 52,5 %; y el 90 %, en el 71,8 %. Los 8 círculos marcan los puntos de mayor peso. MÁS INFO Grad-CAM · Ramprasaath R. Selvaraju, Michael Cogswell, Abhishek Das, Ramakrishna Vedantam, Devi Parikh, Dhruv Batra · 2016Selvaraju, R. R., Cogswell, M., Das, A., Vedantam, R., Parikh, D. y Batra, D. (2016). Grad-CAM: Visual Explanations from Deep Networks via Gradient-based Localization. arxiv.org/abs/1610.02391 ResNet · Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun · 2015 He, K., Zhang, X., Ren, S. y Sun, J. (2015). Deep Residual Learning for Image Recognition. arxiv.org/abs/1512.03385 |
| 08 | 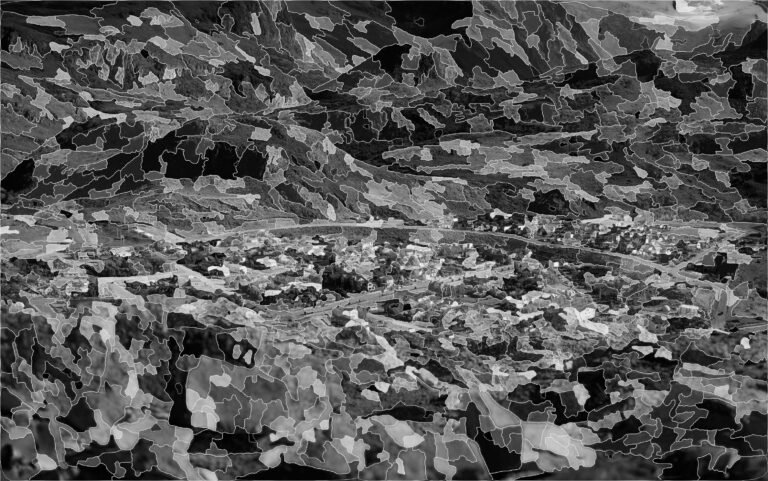 | Watershed bajo el método de gradiente de Meyer.Target: El Chaltén desde el paredón. Timestamp: 2025-2026 | Watershed por marcadores (1992) La imagen tratada como un relieve que se inunda: cada región termina donde se juntan las aguas de dos valles. Régimen segmentario; el resultado es un paisaje celular. El watershed (divisoria de aguas) es un algoritmo matemático, sin entrenamiento. Trata la imagen como un terreno: los valores bajos son valles y los altos, cumbres. Cada valle se llena de agua desde un punto de partida; donde se tocan las aguas de dos valles queda una línea, que es el límite entre dos regiones. La variante que fija de antemano desde qué puntos se llena cada valle es la que describe Fernand Meyer en 1992. Sobre El Chaltén visto desde el paredón, el terreno es cuánto cambia la luz de un píxel al siguiente: donde casi no cambia hay valles; donde cambia de golpe, cumbres. El script puso 1.011 puntos de partida en los fondos de esos valles y obtuvo 885 regiones. MÁS INFO Meyer, F. (1992). Color image segmentation. International Conference on Image Processing and its Applications, 303–306. |
| 09 | 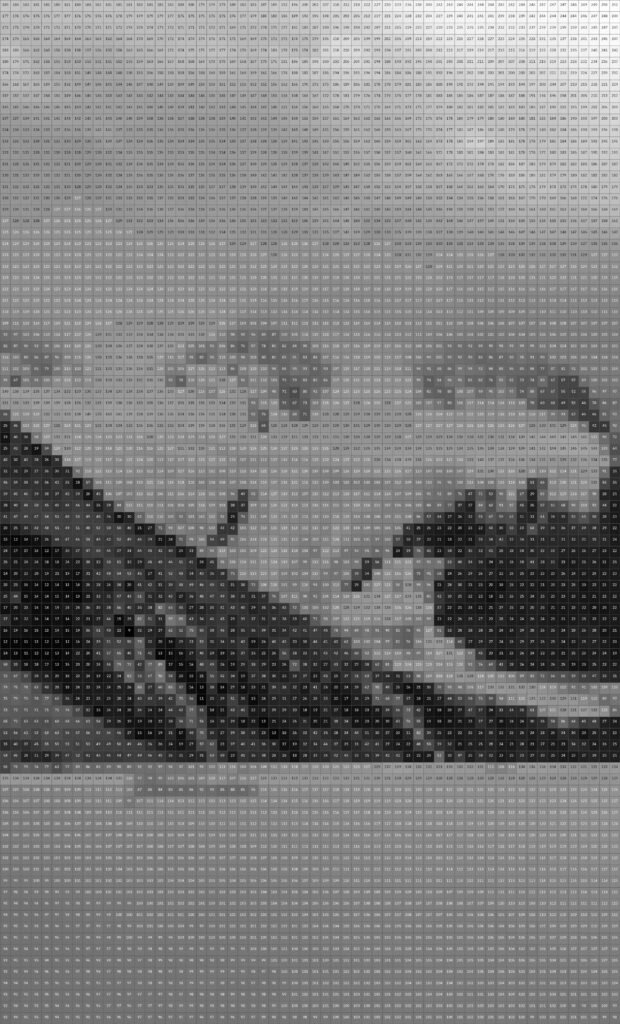 | Extracción de grilla de píxeles / Matriz de datos.Target: Cerro Torre, Parque Nacional Los Glaciares. P2. Timestamp: 2025-2026 | Grilla de píxeles No interviene un modelo ni un algoritmo de visión artificial: es un procedimiento del script. Reduce la fotografía a una grilla de celdas; cada celda toma el color promedio del bloque de píxeles que cubre y muestra un número de 0 a 255: el promedio de su rojo, su verde y su azul. El promedio lo calcula la biblioteca OpenCV. Sobre el Cerro Torre, la grilla completa tiene 120 columnas por 90 filas: 10.800 celdas. Este panel (P2) muestra una de sus dos mitades. |
| 10 | 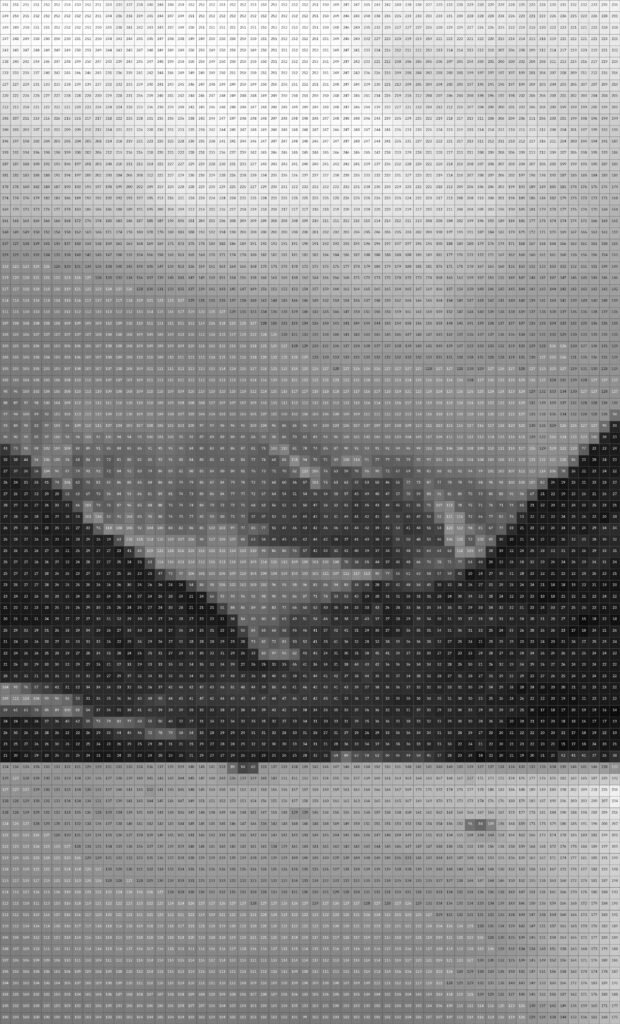 | Extracción de grilla de píxeles / Matriz de datos.Target: Cerro Torre, Parque Nacional Los Glaciares. P1. Timestamp: 2025-2026 | Grilla de píxeles Es la otra mitad de la misma tabla de números: un procedimiento del script, sin modelo de visión. Cada celda guarda el color promedio de su bloque de píxeles y un número de 0 a 255. Este panel (P1) completa la grilla de 10.800 celdas del Cerro Torre. |
| 11 | 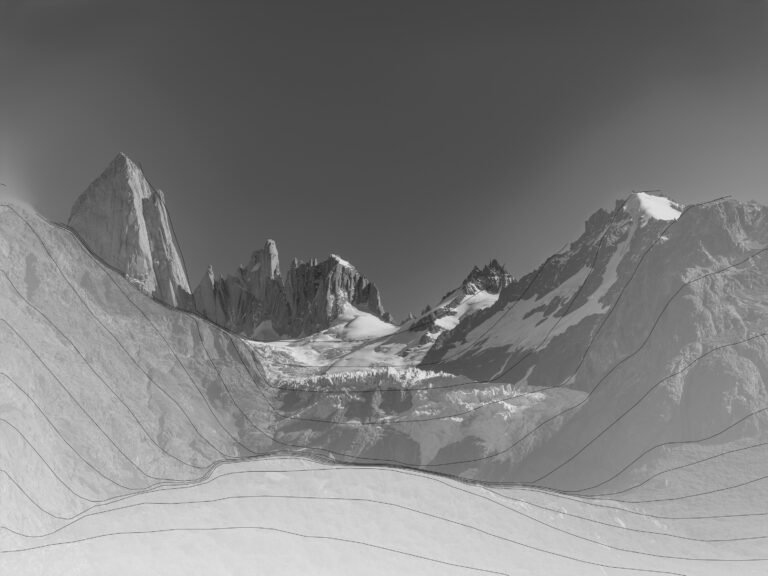 | Modelo MiDaS / Estimación monocular de profundidad a partir de indicios pictóricos.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | MiDaS · DPT-Large (2021) Delante y detrás, con el cielo fuera del cálculo: una profundidad relativa del valle, que produce un paisaje topográfico sin unidad de medida. Régimen geométrico. DPT-Large (2021), de la familia MiDaS, es una red neuronal; su respuesta depende de las imágenes con que fue entrenada. Estima, con una sola fotografía, qué tan cerca o lejos está cada píxel en relación con los demás. Según sus autores, fue diseñado para tareas que asignan un valor a cada píxel de la imagen, como la profundidad, y rinde más cuantos más datos de entrenamiento recibe. La línea MiDaS se entrena mezclando varios conjuntos de datos distintos entre sí; su primera versión sumó una fuente nueva, armada con películas en 3D. En esta vista del Glaciar Piedras Blancas, el script dejó afuera el cielo, que ocupa el 40 % del cuadro, y dibujó la profundidad estimada en 14 niveles. MÁS INFO DPT · René Ranftl, Alexey Bochkovskiy, Vladlen Koltun (Intel) · 2021Ranftl, R., Bochkovskiy, A. y Koltun, V. (2021). Vision Transformers for Dense Prediction. arxiv.org/abs/2103.13413 Ranftl, R., Lasinger, K., Hafner, D., Schindler, K. y Koltun, V. (2019). Towards Robust Monocular Depth Estimation: Mixing Datasets for Zero-shot Cross-dataset Transfer. arxiv.org/abs/1907.01341 |
| 12 | 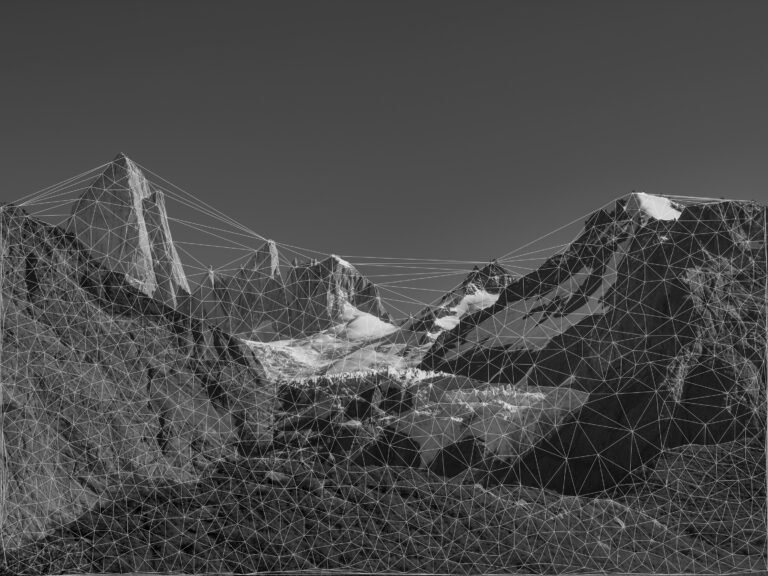 | Triangulación de Delaunay / Extracción de puntos de interés.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Shi-Tomasi (1994) y triangulación de Delaunay Unos pocos puntos de esquina y los triángulos que los unen: la imagen reducida a una malla. Régimen segmentario, paisaje celular de aristas rectas. Intervienen dos algoritmos sin entrenamiento. El de Shi y Tomasi detecta esquinas en la imagen. La triangulación de Delaunay une esos puntos en triángulos con una condición: el círculo que pasa por los tres vértices de cada triángulo no contiene ningún otro punto. El detector de Shi y Tomasi fue presentado en 1994, en el artículo «Good Features to Track», como una mejora del detector de esquinas de Harris. En el valle del glaciar, el script pidió hasta 1.500 esquinas, separadas al menos 60 píxeles entre sí y fuera del cielo; obtuvo 1.141 y las unió en una malla de 3.394 aristas. MÁS INFO Shi, J. y Tomasi, C. (1994). Good features to track. IEEE Conference on Computer Vision and Pattern Recognition (CVPR'94), 593–600. doi.org/10.1109/CVPR.1994.323794 |
| 13 | 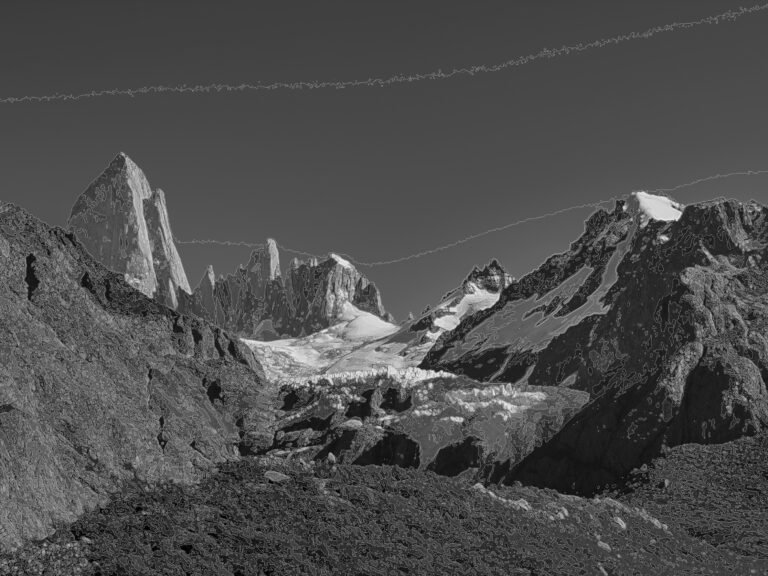 | Análisis topográfico / Capas de altitud.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Marching squares (1987) Régimen geométrico. Las líneas unen los puntos de la fotografía que tienen el mismo brillo, como las curvas de nivel de un mapa unen los puntos de igual altura: un paisaje topográfico hecho de luz. Marching squares es un procedimiento geométrico, sin entrenamiento. Para un valor dado, traza la línea que pasa por todos los puntos de la imagen que tienen ese valor; cuando el valor cae entre dos píxeles, calcula el punto intermedio. Es un caso particular de marching cubes, un algoritmo presentado en 1987 por William Lorensen y Harvey Cline para construir superficies en 3D. En el valle del Glaciar Piedras Blancas, el script tomó el brillo de cada píxel como si fuera una altura, suavizó la imagen y trazó 12 niveles de brillo: 8.468 líneas en total. MÁS INFO Lorensen, W. E. y Cline, H. E. (1987). Marching Cubes: A High Resolution 3D Surface Construction Algorithm. Computer Graphics (SIGGRAPH 87), 21(4), 163–170. doi.org/10.1145/37401.37422 |
| 14 | 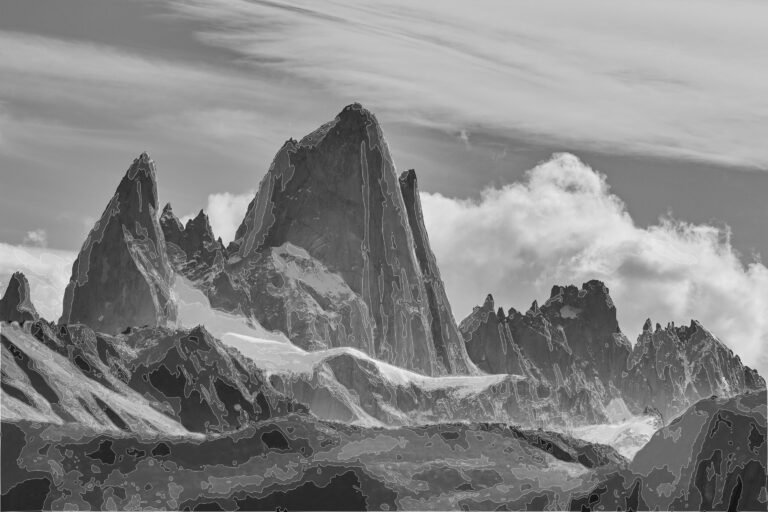 | Cálculo de normales / Desacoplamiento de la iluminación (Shading).Target: Chaltén desde el pueblo. Timestamp: 2025-2026 | Marigold Normals (2025) Hacia dónde se orienta cada parte de la pared, punto por punto. Régimen material; paisaje físico. Marigold Normals (2025) es una red neuronal derivada de un generador de imágenes; lo que devuelve depende de ese origen y de su ajuste. Estima, para cada píxel, hacia dónde se orienta esa porción de superficie respecto de la cámara. Según sus autores, Marigold fue diseñado para aprovechar lo que contienen los generadores de imágenes, como Stable Diffusion, en tareas de análisis de una fotografía: estimar la profundidad o la orientación de las superficies, entre otras. Se ajusta con pocos datos hechos por computadora, en pocos días y con una sola tarjeta gráfica. Sobre el Chaltén visto desde el pueblo, el modelo hizo 4 pasos de cálculo sobre la imagen reducida a 768 píxeles. El script dibuja en 6 franjas cuánto se orienta cada zona hacia la cámara: 776 polígonos. MÁS INFO Marigold · Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov, Konrad Schindler (ETH Zürich) · 2025Ke, B., Qu, K., Wang, T., Metzger, N., Huang, S., Li, B., Obukhov, A. y Schindler, K. (2025). Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis. arxiv.org/abs/2505.09358 |
| 15 | 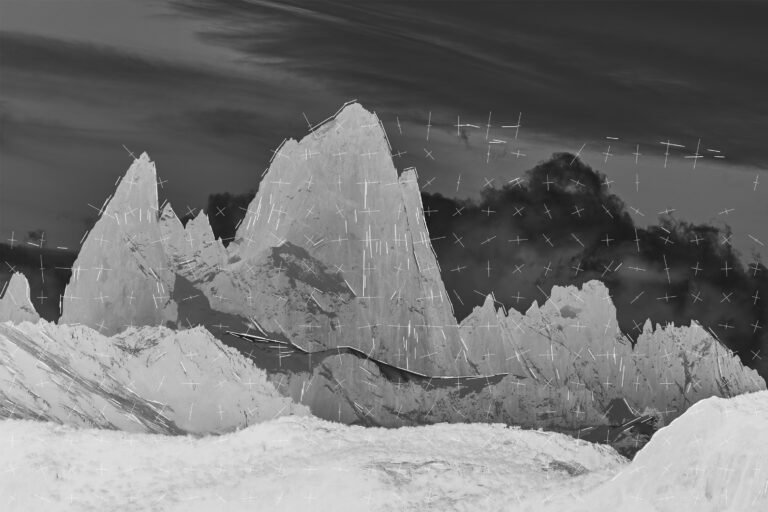 | Análisis de fracturas / Red de fallas y matriz de tensión.Target: Chaltén desde el pueblo. Timestamp: 2025-2026 | Canny (1986) y LSD (2012) Por dónde se quiebra la pared y en qué direcciones: líneas rectas y una grilla de cruces en lugar de una silueta: un paisaje celular de grietas, dentro del régimen segmentario. Tres cálculos sin entrenamiento trabajan juntos. El detector de Canny marca los bordes. LSD convierte esos bordes en tramos rectos. Una grilla de cruces indica, en cada punto, la dirección en que la imagen cambia más y la dirección en que cambia menos. El detector de Canny fue desarrollado por John F. Canny en 1986. LSD fue publicado en 2012 por Rafael Grompone von Gioi, Jérémie Jakubowicz, Jean-Michel Morel y Gregory Randall. En el Chaltén visto desde el pueblo, el script separó el cielo, que ocupa el 30 % del cuadro, y detectó 213 fallas. Un grupo de 71 fallas comparte una misma dirección: alrededor de 88°, con un margen de 15°. Las cruces son 310. La silueta del pico se usa para recortar y no se dibuja. MÁS INFO Canny, J. (1986). A computational approach to edge detection. IEEE Transactions on Pattern Analysis and Machine Intelligence, 8(6), 679–698. doi.org/10.1109/TPAMI.1986.4767851Grompone von Gioi, R., Jakubowicz, J., Morel, J.-M. y Randall, G. (2012). LSD: a Line Segment Detector. Image Processing On Line, 2, 35–55. doi.org/10.5201/ipol.2012.gjmr-lsd |
| 16 | 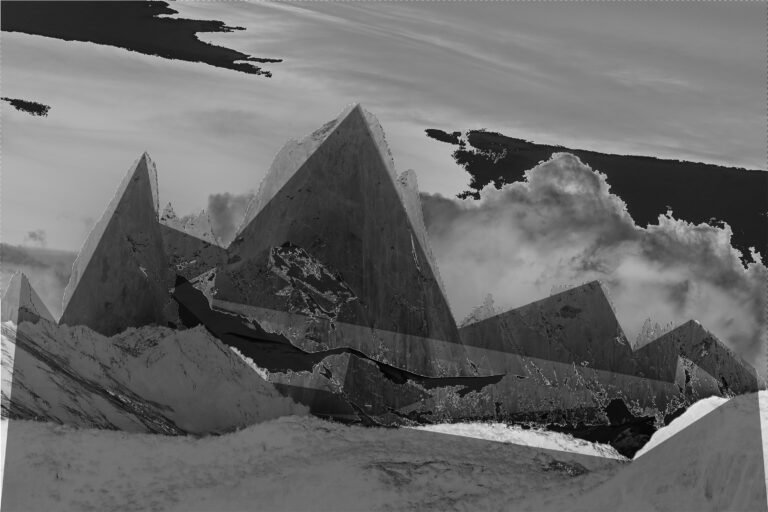 | Método de Otsu / Umbralización y segmentación morfológica.Target: Chaltén desde el pueblo. Timestamp: 2025-2026 | Método de Otsu Un solo valor de luz divide la imagen en dos: lo que queda por encima y lo que queda por debajo. Régimen segmentario, paisaje celular en blanco y negro. El método de Otsu es un cálculo estadístico, sin entrenamiento: según cuántos píxeles hay de cada nivel de brillo, calcula un único valor de corte y separa la fotografía en dos. Según la documentación de OpenCV, su ventaja es que ese valor no se fija a mano: el método lo calcula solo. Sobre el Chaltén visto desde el pueblo, el corte dejó el 44,4 % del cuadro en negro y el 55,6 % en blanco, repartidos en 42 regiones negras, 32 blancas y 48 huecos. MÁS INFO Otsu, N. (1979). A Threshold Selection Method from Gray-Level Histograms. IEEE Transactions on Systems, Man, and Cybernetics, 9(1), 62–66. doi.org/10.1109/TSMC.1979.4310076 |
| 17 | 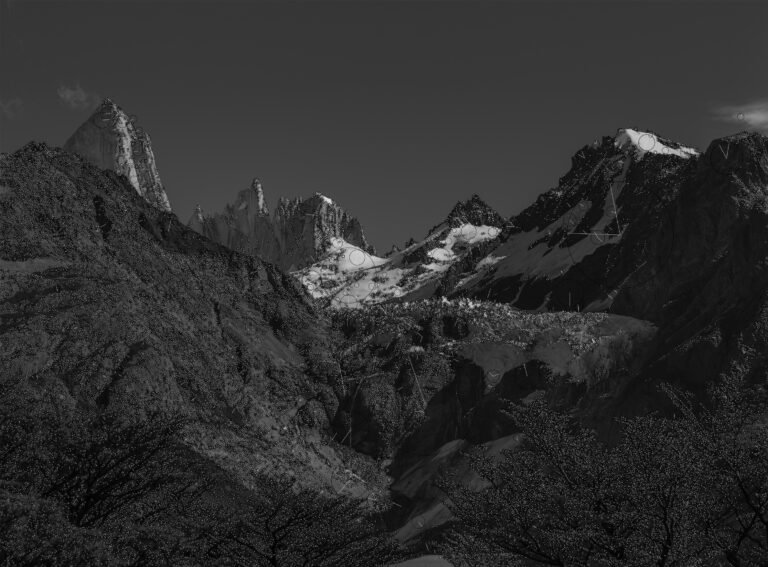 | Detección de bordes. SIFT.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | SIFT (2004) Puntos que siguen siendo reconocibles aunque la imagen se agrande o se achique: la fotografía convertida en un repertorio de rasgos. Régimen matemático, paisaje de afinidades. SIFT es un algoritmo matemático que no traza bordes: localiza puntos característicos y guarda, para cada uno, una descripción en números de su entorno, que permite volver a encontrarlo en otra imagen. Según la documentación de OpenCV, fue presentado en 2004 por David Lowe, de la Universidad de Columbia Británica, para resolver un problema de los detectores de esquinas anteriores: una esquina deja de reconocerse como tal cuando la imagen cambia de tamaño. Cada punto del valle aparece como un círculo: su tamaño corresponde al tamaño del rasgo, y la línea que sale del centro indica su orientación. MÁS INFO Lowe, D. G. (2004). Distinctive Image Features from Scale-Invariant Keypoints. International Journal of Computer Vision, 60(2), 91–110. doi.org/10.1023/B:VISI.0000029664.99615.94 |
| 18 | 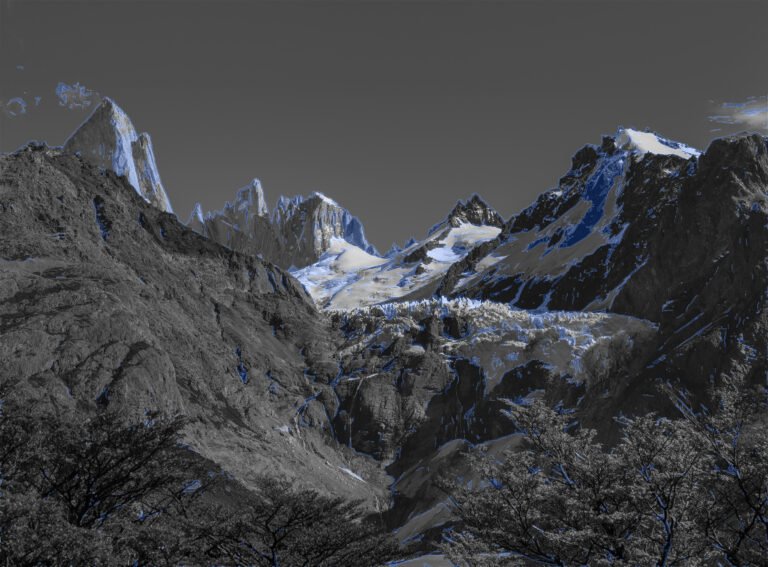 | Detección de bordes. BDCN.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | BDCN (2019) Bordes detectados por capas, cada una dedicada a un tamaño distinto de detalle: un paisaje celular hecho por niveles, en régimen segmentario. BDCN (2019) es una red neuronal: los bordes que devuelve dependen de su entrenamiento. Sus capas están conectadas en cascada, en dos sentidos, y cada una se ocupa de un tamaño de detalle. Según sus autores, fue diseñado para detectar bordes, con una parte añadida que mejora la información en los distintos tamaños. El script procesó la fotografía completa del glaciar en partes de 1024 píxeles y conservó solo los bordes más marcados: 2.586 líneas, que cubren el 4,8 % de la imagen. MÁS INFO Bi-Directional Cascade Network for Perceptual Edge Detection. arxiv.org/abs/1902.10903 |
| 19 | 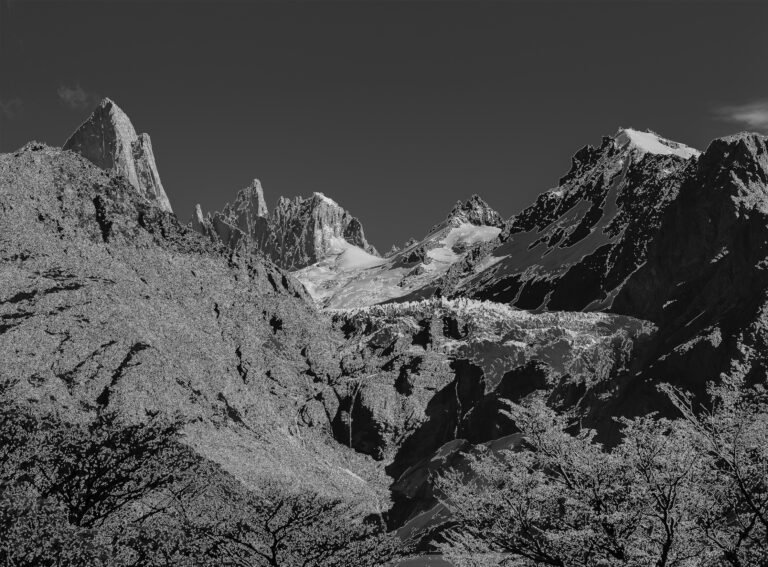 | Detección de bordes. Canny.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Canny (1986) Un borde existe solo si la luz cambia lo suficiente o si está unido a otro borde fuerte. Régimen segmentario: un paisaje celular de bordes encadenados. El detector de Canny trabaja por etapas: suaviza la imagen para quitar ruido, calcula cuánto y en qué dirección cambia la luz, afina cada borde hasta dejarlo en una línea y lo somete a dos valores de corte: lo que supera el más alto queda; lo que está entre ambos queda solo si toca un borde que ya quedó. Fue desarrollado por John F. Canny en 1986. En el valle del glaciar, los tramos débiles sueltos desaparecen; quedan los que se encadenan a un borde fuerte. MÁS INFO Canny, J. (1986). A computational approach to edge detection. IEEE Transactions on Pattern Analysis and Machine Intelligence, 8(6), 679–698. doi.org/10.1109/TPAMI.1986.4767851 |
| 20 | 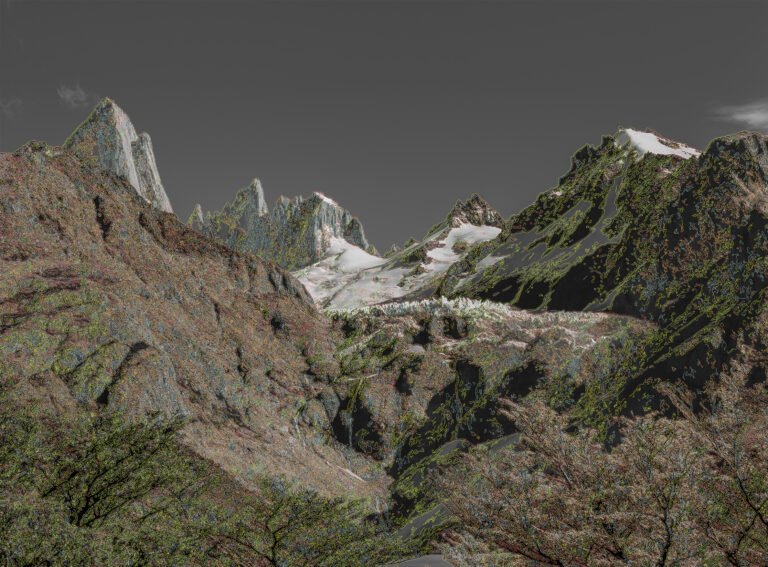 | Detección de bordes. Cromática.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Banco de filtros de Gabor en 8 orientaciones Ocho direcciones posibles y un color para cada una: el relieve convertido en un campo de orientaciones: un paisaje celular en ocho colores, del régimen segmentario. Ocho filtros de Gabor —fórmulas fijas, sin entrenamiento— recorren la imagen; cada uno responde a las líneas que van en una dirección. Cada trazo recibe el color de la dirección que más pesa en él. En la vista del Glaciar Piedras Blancas, el resultado es un mapa de direcciones: el color dice hacia dónde va cada trazo. MÁS INFO Gabor, D. (1946). Theory of communication. Part 1: The analysis of information. Journal of the Institution of Electrical Engineers, Part III, 93(26), 429–441. doi.org/10.1049/ji-3-2.1946.0074 |
| 21 | 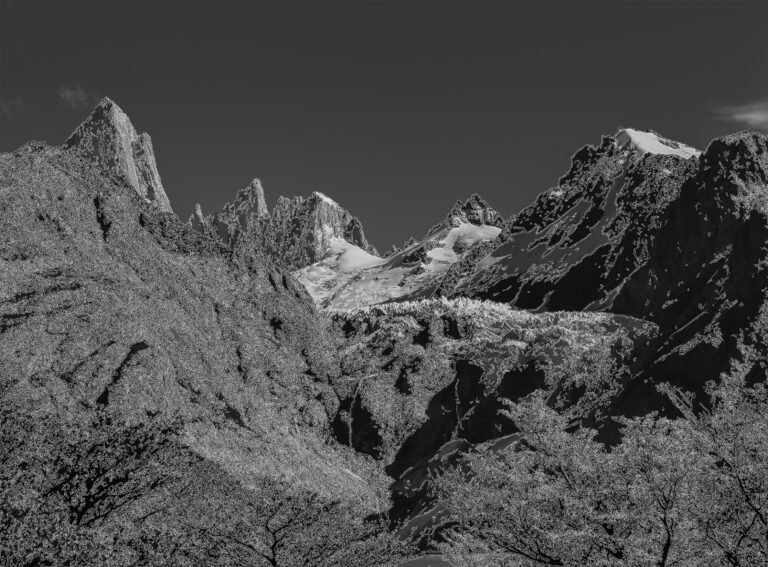 | Detección de bordes. Congruencia de fase.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Congruencia de fase (aproximación con filtros de Gabor) Bordes que aparecen donde coinciden las ondas de distintos tamaños que forman la imagen: un paisaje celular de coincidencias, en el régimen segmentario. Cuatro filtros de Gabor, sin entrenamiento, localizan los puntos donde coinciden las ondas de distintos tamaños que forman la imagen, y allí marcan un borde. Es una aproximación al método de congruencia de fase de Peter Kovesi (1999). Sobre el valle, el script dibuja solo los puntos donde esas ondas coinciden. MÁS INFO Kovesi, P. (1999). Image Features From Phase Congruency. Videre: A Journal of Computer Vision Research, 1(3). MIT Press. cs.rochester.edu/~brown/Videre/001/articles/v1n3001.pdf |
| 22 | 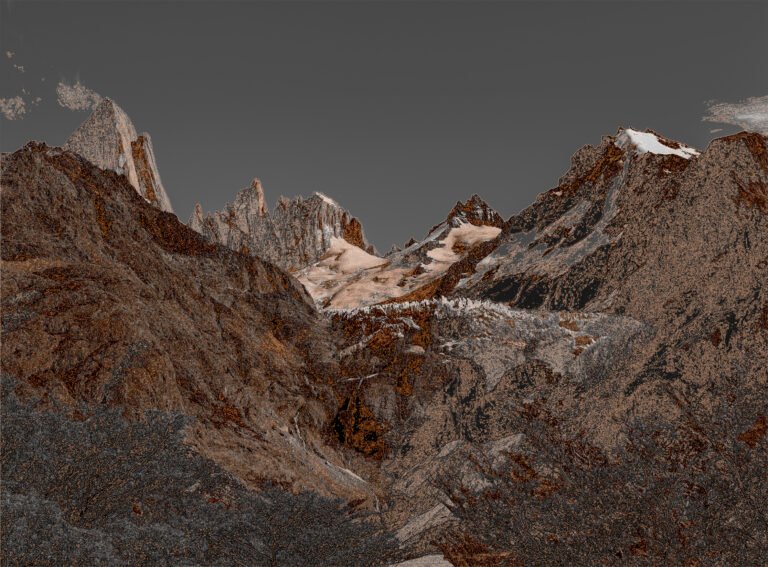 | Detección de bordes. Prewitt.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Operador de Prewitt La diferencia de luz entre vecinos, con todos los píxeles del entorno pesando lo mismo: un paisaje celular sin jerarquías, de régimen segmentario. El operador de Prewitt es una operación aritmética sobre los píxeles: en cada píxel enfrenta la luz de un lado con la del otro, dando el mismo peso a todos los vecinos. Aplicado a la fotografía completa del glaciar, cada borde sale de ese cálculo parejo, sin vecinos privilegiados, y se convierte en un trazo. |
| 23 | 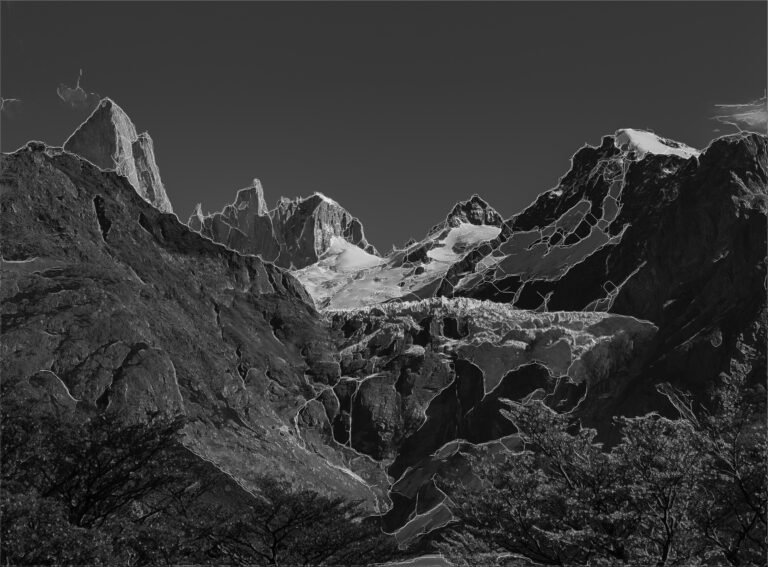 | Detección de bordes. HED.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | HED (2015) Contornos que dependen de un entrenamiento con ejemplos, en cinco niveles de detalle superpuestos: el régimen segmentario dibujado por una red, como paisaje celular. HED (2015) es una red neuronal; cada borde que devuelve depende de su entrenamiento. Entrega un mapa de bordes del mismo tamaño que la fotografía, que combina cinco niveles de detalle. Creado por Saining Xie en la Universidad de California en San Diego, según sus autores fue diseñado para resolver la ambigüedad al detectar bordes y contornos de objetos. Lo evaluaron sobre los conjuntos de imágenes BSD500 y NYU Depth. Sobre el valle, el modelo devolvió un mapa con la intensidad de borde de cada punto, que el script convirtió en trazos. MÁS INFO HED · Saining Xie (UC San Diego), Zhuowen Tu · 2015Xie, S. y Tu, Z. (2015). Holistically-Nested Edge Detection. IEEE International Conference on Computer Vision (ICCV). arxiv.org/abs/1504.06375 |
| 24 | 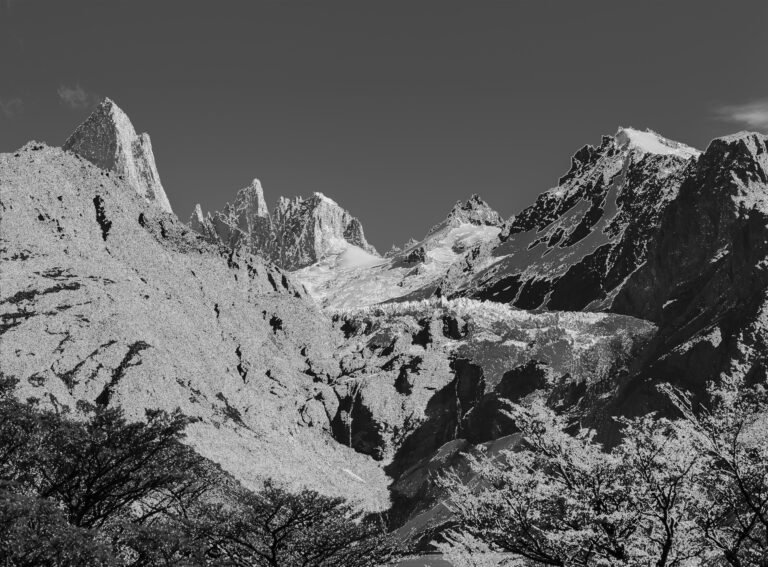 | Detección de bordes. Laplace.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Operador laplaciano No dónde cambia la luz, sino dónde ese cambio se acelera o se frena: el régimen segmentario calculado sobre la curvatura de la luz, que deja un paisaje celular. El operador laplaciano es una fórmula matemática. No calcula cuánto cambia la luz, sino cómo varía ese cambio, en horizontal y en vertical. En la fotografía del glaciar, el operador responde a las curvas del brillo y no a su inclinación; el script convierte esa respuesta en trazos. MÁS INFO Documentación de OpenCV, función Laplacian. docs.opencv.org/4.x/d4/d86/group__imgproc__filter.html |
| 25 | 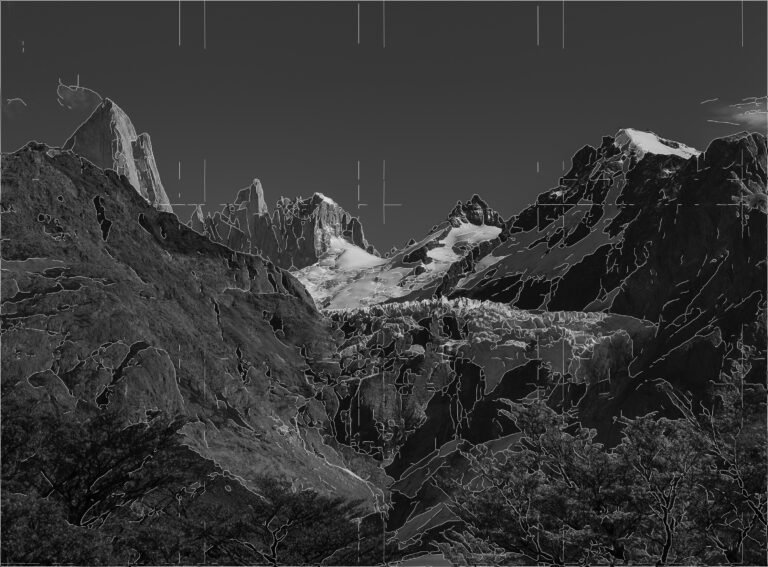 | Detección de bordes. RCF.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | RCF (2019) Bordes marcados por otra red, con sus propios ejemplos de entrenamiento: el mismo valle, otro paisaje celular, en régimen segmentario. RCF (2019) es una red neuronal; lo que marca como borde depende de su entrenamiento. Sus autores publicaron versiones entrenadas con dos conjuntos de imágenes: BSDS500 y NYUD. Frente al glaciar, el modelo devolvió un mapa de bordes que el script convirtió en trazos. MÁS INFO Liu, Y., Cheng, M.-M., Hu, X., Bian, J.-W., Zhang, L., Bai, X. y Tang, J. (2019). Richer Convolutional Features for Edge Detection. IEEE Transactions on Pattern Analysis and Machine Intelligence, 41(8), 1939–1946. doi.org/10.1109/TPAMI.2018.2878849 |
| 26 | 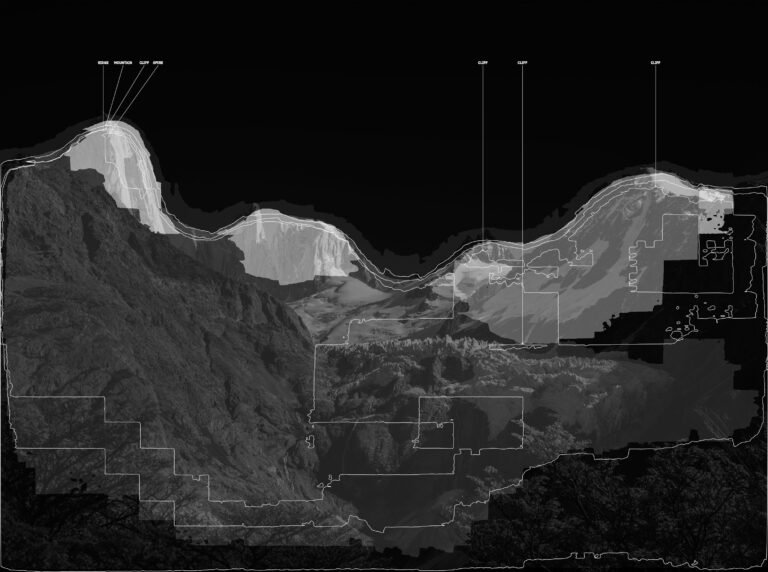 | Segmentación basada en lenguaje. CLIPSeg.Target: Cara Oeste del macizo del Fitz Roy y el Cerro Torre. Timestamp: 2025-2026 | CLIPSeg (2021) Veinte palabras en inglés y la zona de la imagen que corresponde a cada una: el régimen segmentario pasado por el lenguaje. Paisaje celular. CLIPSeg (2021) es una red neuronal entrenada con imágenes y frases; lo que devuelve depende de ese entrenamiento. Recibe una fotografía y una palabra o frase, y devuelve la zona de la imagen que corresponde a ese texto. Según sus autores, fue diseñado para recortar zonas de una imagen con cualquier texto o imagen de ejemplo, sin volver a entrenarlo para cada palabra nueva. Se apoya en CLIP, un modelo que relaciona imágenes y textos; fue entrenado con una versión ampliada del conjunto PhraseCut. Sobre la cara oeste del macizo del Fitz Roy y el Cerro Torre, el script le entregó al modelo esta lista: mountain, peak, spire, ridge, cliff, snow, glacier, ice, rock, scree, vegetation, shrub, tree, river, waterfall, sky, building, house, roof, road. Cada zona del dibujo lleva la palabra que le tocó. MÁS INFO CLIPSeg · Timo Lüddecke, Alexander Ecker · 2021Lüddecke, T. y Ecker, A. (2022). Image Segmentation Using Text and Image Prompts. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 7086–7096. arxiv.org/abs/2112.10003 |
| 27 | 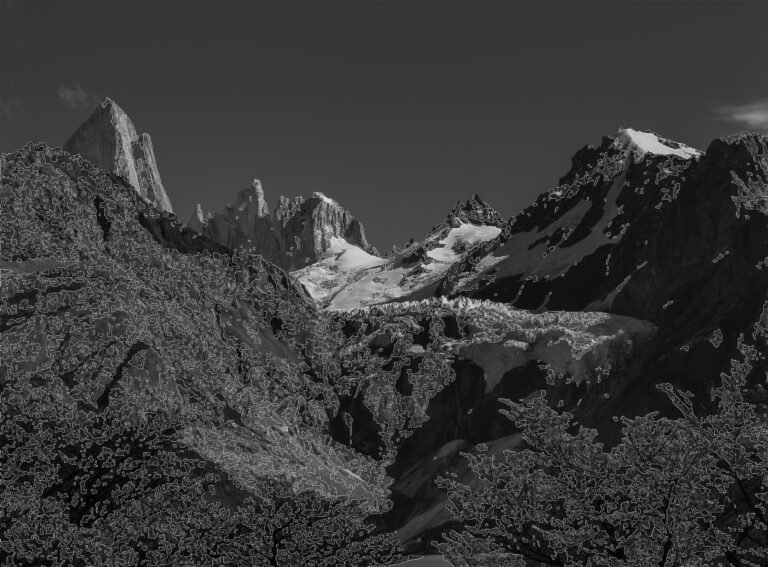 | Detección de bordes. Roberts.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Operador cruzado de Roberts Bordes en diagonal, calculados en cuadrados de apenas cuatro píxeles: régimen segmentario y paisaje celular a escala mínima. El operador cruzado de Roberts, también sin entrenamiento, contrasta la luz, en cada cuadrado de 2 × 2 píxeles, en las dos diagonales. Sobre el valle, cada borde sale de un cuadrado de cuatro píxeles; el script lo convierte en un trazo. MÁS INFO Roberts, L. G. (1963). Machine perception of three-dimensional solids. Tesis doctoral, Massachusetts Institute of Technology. dspace.mit.edu/handle/1721.1/11589 |
| 28 | 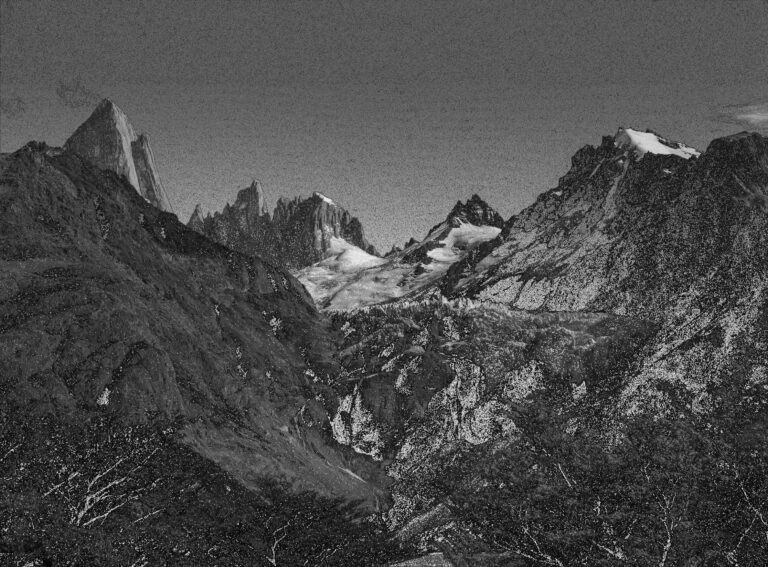 | Detección de bordes. Scharr.Target: Glaciar Piedras Blancas. El Chaltén. Timestamp: 2025-2026 | Operador de Scharr El cambio de luz y su dirección, con una respuesta más pareja en todas las orientaciones: el régimen segmentario sin dirección preferida, en un paisaje celular. El operador de Scharr es otra fórmula fija que calcula cuánto cambia la luz en cada píxel, mirando sus vecinos en un cuadrado de 3 × 3. Según la documentación de OpenCV, es más preciso que el operador de Sobel del mismo tamaño; según la de scikit-image, responde de manera más pareja en todas las direcciones que Sobel o Prewitt. Aplicado a la vista del glaciar, el operador marca bordes en todas las direcciones del relieve, y el script los convierte en trazos. MÁS INFO Scharr, H. (2000). Optimale Operatoren in der Digitalen Bildverarbeitung. Tesis doctoral, Universidad de Heidelberg. ub.uni-heidelberg.de/archiv/962Documentación de OpenCV, función Scharr. docs.opencv.org/4.x/d4/d86/group__imgproc__filter.html |
| 29 | 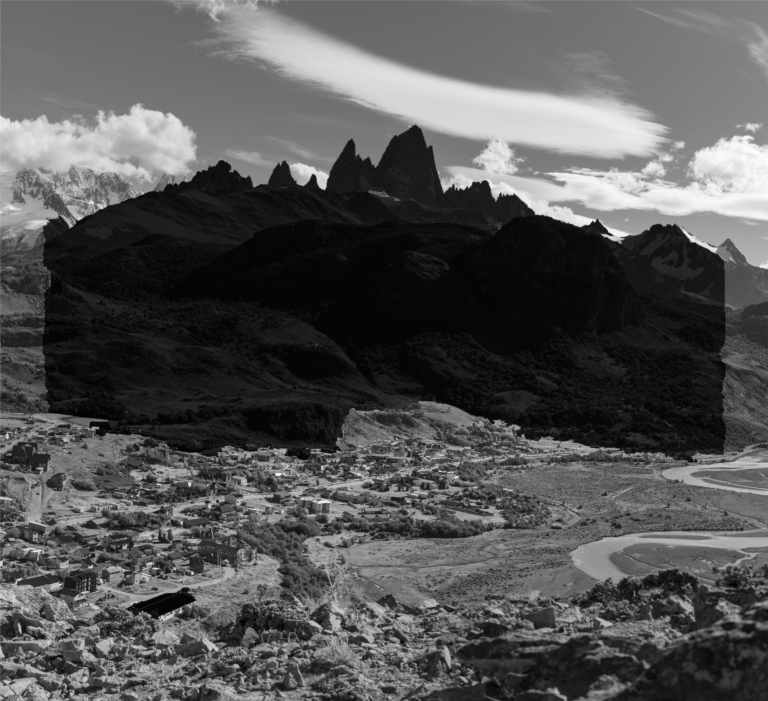 | GrabCut. Encuentra grandes formas.Target: El Chaltén desde el paredón. Timestamp: 2025-2026 | GrabCut Qué se desprende del borde de la fotografía como primer plano: el régimen segmentario reducido a figura y fondo, en un paisaje celular de apenas tres regiones. GrabCut es un algoritmo sin entrenamiento que separa el primer plano del fondo. Empieza con una zona que se le indica como fondo y, en vueltas sucesivas, clasifica el resto de los píxeles como figura o como fondo. Según la documentación de OpenCV, fue diseñado por Carsten Rother, Vladimir Kolmogorov y Andrew Blake, de Microsoft Research Cambridge, para separar el primer plano con una intervención mínima de una persona: en su uso habitual, alguien dibuja un rectángulo alrededor del objeto. Sobre El Chaltén visto desde el paredón, el script no usó un rectángulo dibujado a mano: tomó como fondo una franja en el borde de la fotografía, hizo 5 vueltas y obtuvo 3 regiones. MÁS INFO Rother, C., Kolmogorov, V. y Blake, A. "GrabCut": interactive foreground extraction using iterated graph cuts. dl.acm.org/citation.cfm?id=1015720 |
| 30 | 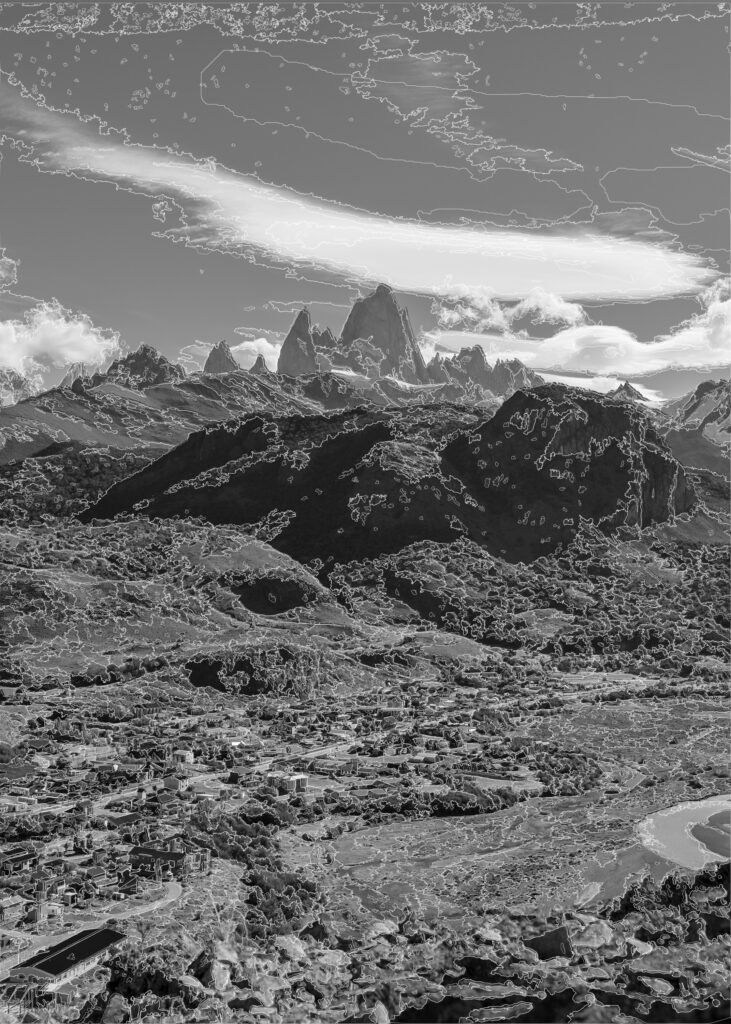 | Felzenszwalb, técnica de bajo nivel (sin semántica).Target: El Chaltén desde el paredón. Timestamp: 2025-2026 | Felzenszwalb-Huttenlocher (2004) Regiones de color sin nombre, armadas uniendo píxeles vecinos: el paisaje celular de un régimen segmentario sin palabras. El algoritmo de Felzenszwalb y Huttenlocher no usa entrenamiento: trata la imagen como una red de píxeles conectados con sus vecinos y los agrupa en regiones. Fue publicado en 2004 como un método rápido para dividir una imagen en regiones. Sobre El Chaltén visto desde el paredón, el algoritmo produjo 7.383 regiones, con un mínimo de 80 píxeles cada una; el script conserva 2.003. MÁS INFO Felzenszwalb, P. F. y Huttenlocher, D. P. (2004). Efficient graph-based image segmentation. International Journal of Computer Vision, 59(2), 167–181. doi.org/10.1023/B:VISI.0000022288.19776.77 |
| 31 | 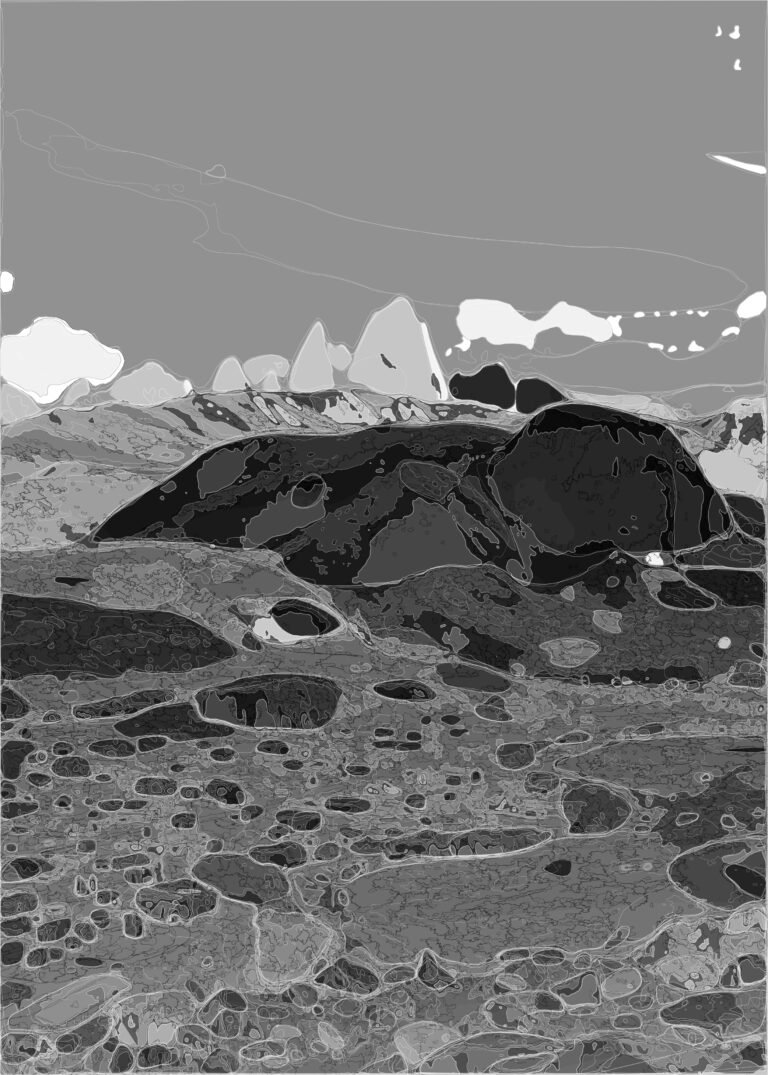 | Fusión de técnicas de bajo nivel (sin semántica) sin imagen de fondo.Target: El Chaltén desde el paredón. Timestamp: 2025-2026 | SAM con TTA (2023), HQ-SAM (2023) y Felzenszwalb-Huttenlocher (2004) Tres segmentaciones de la misma vista, fundidas y sin la fotografía debajo: del paisaje quedan solo sus contornos. Régimen segmentario; paisaje celular. Se superponen dos modelos y un algoritmo. SAM y HQ-SAM son redes neuronales que dividen la imagen en máscaras, zonas cerradas, sin decir qué hay en cada una. Con TTA, el script le entrega a SAM la foto tres veces —tal cual, espejada de izquierda a derecha y espejada de arriba abajo— y reúne lo que devuelve en cada pasada. El de Felzenszwalb y Huttenlocher es un algoritmo sin entrenamiento: une píxeles vecinos parecidos en regiones. SAM se presentó en 2023 como un modelo para recortar cualquier cosa en una imagen; HQ-SAM, el mismo año, como una extensión para obtener bordes más precisos. Felzenszwalb y Huttenlocher publicaron su método en 2004. Las tres corrieron el 31 de agosto de 2026 sobre El Chaltén visto desde el paredón: SAM con TTA retuvo 433 máscaras; HQ-SAM, 260; Felzenszwalb, 2.003 regiones. Ese mismo día, las capas vectoriales se fundieron en Photoshop, sin la imagen de fondo. MÁS INFO Kirillov, A. et al. (2023). Segment Anything. arxiv.org/abs/2304.02643Ke, L. et al. (2023). Segment Anything in High Quality. arxiv.org/abs/2306.01567 Felzenszwalb, P. F. y Huttenlocher, D. P. (2004). Efficient graph-based image segmentation. International Journal of Computer Vision, 59(2), 167–181. doi.org/10.1023/B:VISI.0000022288.19776.77 |
| 32 | 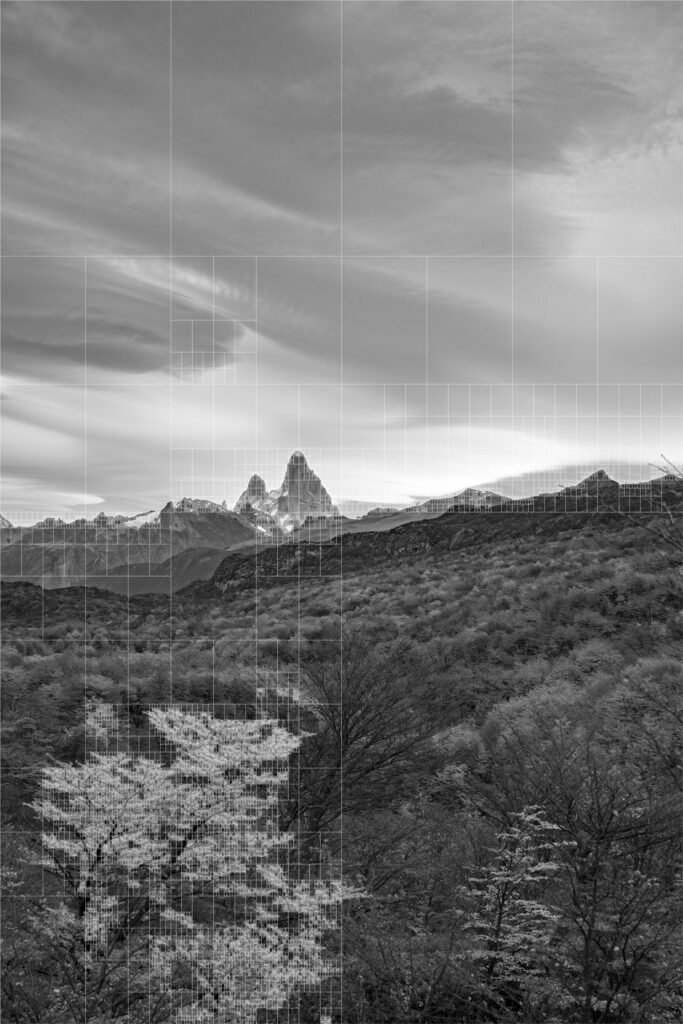 | Quadtree subdivide la imagen por varianza estadística.Target: Sendero al Glaciar Huemul. Timestamp: 2025-2026 | Quadtree Bloques grandes donde la imagen es pareja, bloques mínimos donde varía: un paisaje celular en forma de mosaico, según el régimen segmentario. Es un procedimiento escrito en el script: divide el cuadro en cuatro, calcula cuánto varía la luz dentro de cada parte y vuelve a dividir solo las partes que varían más que un límite fijado. En el sendero al Glaciar Huemul, el resultado tiene 13.810 celdas: las más grandes ocupan la mitad del ancho de la fotografía; las más chicas, 1/512 de ese ancho. 11.060 celdas tienen el tamaño mínimo. |
| 33 | 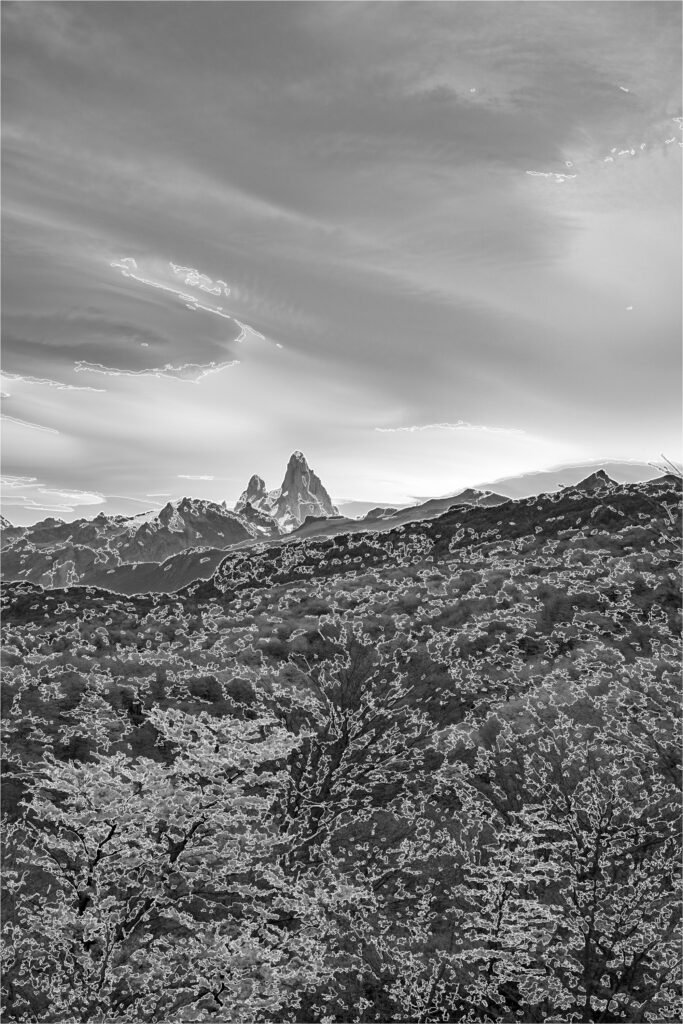 | Segmentos. Felzenszwalb.Target: Sendero al Glaciar Huemul. Timestamp: 2025-2026 | Felzenszwalb-Huttenlocher (2004) La misma ladera del sendero, ahora en regiones irregulares que no corresponden a ningún nombre: frente al mosaico de la obra 33, otro paisaje celular del régimen segmentario. Es el mismo método de la obra 31, de Felzenszwalb y Huttenlocher (2004): un procedimiento que agrupa píxeles vecinos en regiones. Sobre el sendero al Glaciar Huemul, el dibujo resultante tiene 12.390 contornos. MÁS INFO Felzenszwalb, P. F. y Huttenlocher, D. P. (2004). Efficient graph-based image segmentation. International Journal of Computer Vision, 59(2), 167–181. doi.org/10.1023/B:VISI.0000022288.19776.77 |
| 34 | 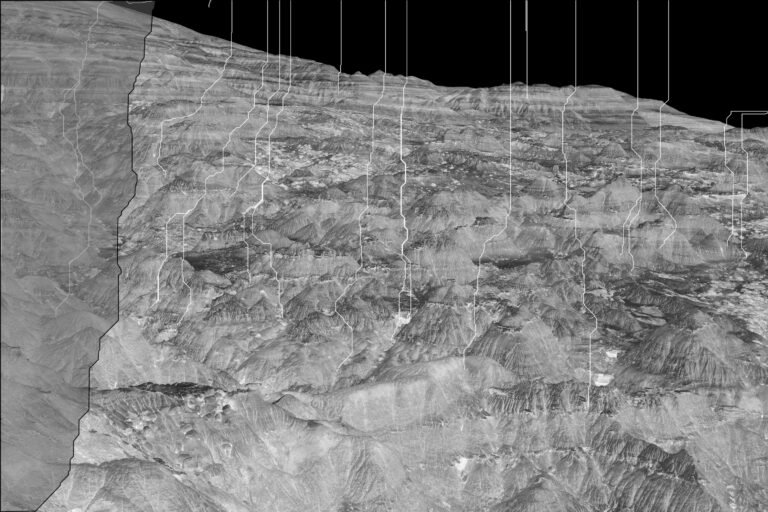 | Cuencas, parte el territorio por destino del agua. Drenaje mide el orden de Strahler.Target: Bosque Petrificado La Leona. Timestamp: 2025-2026 | Depth Anything V2 Large (2024) y red de drenaje D8 Hacia dónde correría el agua sobre un relieve que no se relevó en el terreno, sino que se estimó desde una fotografía. Régimen geométrico; paisaje topográfico. Son dos pasos. Primero, Depth Anything V2 (2024), una red neuronal cuya respuesta depende de su entrenamiento, estima el relieve. Después, cálculos sin entrenamiento simulan el agua: rellenan los pozos para que no quede atrapada, mandan el agua de cada punto hacia el vecino más bajo y suman cuánta agua pasa por cada lugar. Los cauces se numeran según Strahler: un cauce que nace es de orden 1; cuando se juntan dos del mismo orden, el que sigue sube un orden; si son distintos, conserva el mayor. Cada punto del terreno drena hacia una única salida; así el territorio queda dividido en cuencas. Sobre el Bosque Petrificado La Leona, el script obtuvo 1.238 cuencas y destaca la más grande, el 14,6 % del cuadro. La red de drenaje tiene 38 tramos: 28 de orden 1 y 10 de orden 2. No hay metros ni norte en este relieve. MÁS INFO Depth Anything V2 · Lihe Yang, Hengshuang Zhao (HKU) · Bingyi Kang, Zilong Huang, Jiashi Feng (TikTok) · Zhen Zhao, Xiaogang Xu · 2024Yang, L., Kang, B., Huang, Z., Zhao, Z., Xu, X., Feng, J. y Zhao, H. (2024). Depth Anything V2. arxiv.org/abs/2406.09414 O'Callaghan, J. F. y Mark, D. M. (1984). The extraction of drainage networks from digital elevation data. Computer Vision, Graphics, and Image Processing, 28(3), 323–344. doi.org/10.1016/S0734-189X(84)80011-0 |
| 35 | 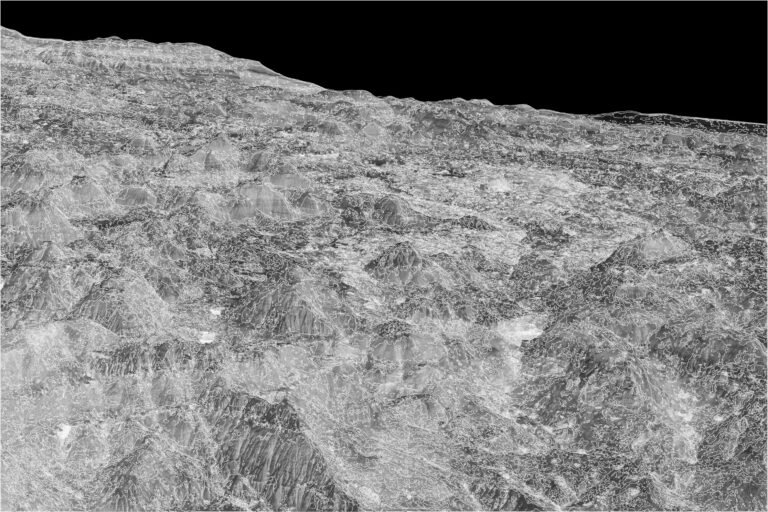 | Marigold, calcula la orientación X/Y/Z de cada milímetro de superficie y separa el relieve real de la iluminación del sol.Target: Bosque Petrificado La Leona. Timestamp: 2025-2026 | Marigold Normals (2025) El terreno erosionado descompuesto en planos, cada uno con su orientación respecto de la cámara. Régimen material, paisaje físico. Marigold Normals (2025), como en la obra 13: una red neuronal derivada del generador de imágenes Stable Diffusion, estima hacia dónde se orienta cada punto de la superficie. Según sus autores, Marigold lleva a tareas de análisis de imagen lo que contienen los generadores de imágenes, y se ajusta con pocos datos hechos por computadora. En el Bosque Petrificado La Leona, el modelo hizo 8 pasos de cálculo y promedió 5 resultados, sobre la imagen a 1280 píxeles. El script dibuja en 7 franjas cuánto se orienta cada zona hacia la cámara: 8.827 polígonos. MÁS INFO Marigold · Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov, Konrad Schindler (ETH Zürich) · 2025Ke, B., Qu, K., Wang, T., Metzger, N., Huang, S., Li, B., Obukhov, A. y Schindler, K. (2025). Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis. arxiv.org/abs/2505.09358 |
| 36 | 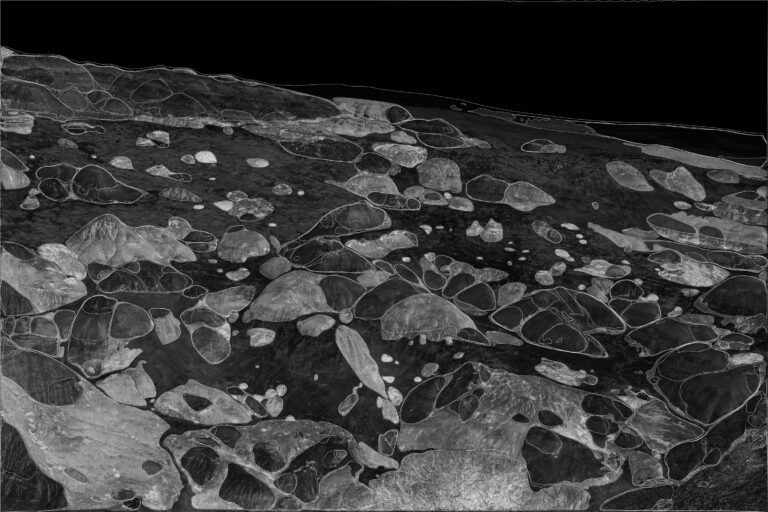 | SAM / SAM1 / SAM_HQ / SAM2 / TTA.Target: Bosque Petrificado La Leona. P1. Timestamp: 2025-2026 | SAM (2023) y HQ-SAM (2023) Dos versiones del mismo modelo sobre el mismo terreno, y dos recuentos distintos de formas: un paisaje celular que cambia según la versión, en régimen segmentario. SAM (2023), como en la obra 17, recorta objetos en máscaras —zonas cerradas de la imagen— según su entrenamiento. HQ-SAM le agrega una parte pequeña, alrededor del 0,5 % del modelo, para que las máscaras sigan mejor los bordes y los detalles finos. SAM fue creado en Meta AI Research (FAIR) y entrenado con más de 1.000 millones de máscaras. HQ-SAM, desarrollado en ETH Zürich y HKUST, se construye sobre SAM y se entrena con 44.000 máscaras de alta calidad. Sobre el Bosque Petrificado La Leona, ambas en su versión más grande (ViT-H): SAM devolvió 471 máscaras en su configuración más densa; HQ-SAM, 101. MÁS INFO SAM · Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick (Meta AI Research, FAIR) · 2023Kirillov, A. et al. (2023). Segment Anything. arxiv.org/abs/2304.02643 HQ-SAM · Lei Ke, Mingqiao Ye, Martin Danelljan, Yifan Liu, Yu-Wing Tai, Chi-Keung Tang, Fisher Yu (ETH Zürich y HKUST) · 2023 Ke, L. et al. (2023). Segment Anything in High Quality. arxiv.org/abs/2306.01567 |
| 37 | 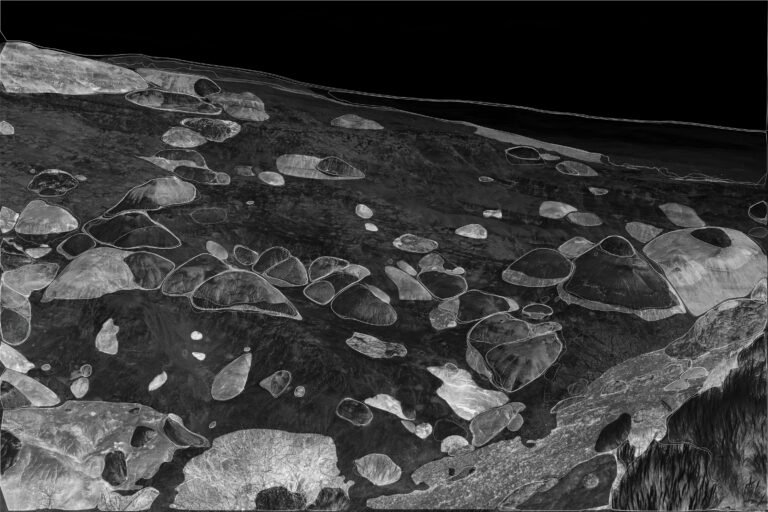 | SAM / SAM1 / SAM_HQ / SAM2 / TTA.Target: Bosque Petrificado La Leona. P2. Timestamp: 2025-2026 | SAM (2023), HQ-SAM (2023) y TTA Tres maneras de procesar la misma fotografía —una de ellas espejada— y tres recuentos de formas: el régimen segmentario puesto a prueba en tres paisajes celulares. Las tres corridas usan SAM (2023) o su variante HQ-SAM, como en la obra 37. La tercera (TTA) pasa la foto tres veces por el modelo —tal cual, espejada de izquierda a derecha y espejada de arriba abajo— y junta los resultados. Sobre el Bosque Petrificado La Leona, el mismo día: SAM devolvió 118 máscaras; HQ-SAM, 119; y SAM con TTA, 256. MÁS INFO SAM · Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick (Meta AI Research, FAIR) · 2023Kirillov, A. et al. (2023). Segment Anything. arxiv.org/abs/2304.02643 HQ-SAM · Lei Ke, Mingqiao Ye, Martin Danelljan, Yifan Liu, Yu-Wing Tai, Chi-Keung Tang, Fisher Yu (ETH Zürich y HKUST) · 2023 Ke, L. et al. (2023). Segment Anything in High Quality. arxiv.org/abs/2306.01567 |